Как выбрать инфраструктуру для AI: CPU, RAM, GPU и хранилище
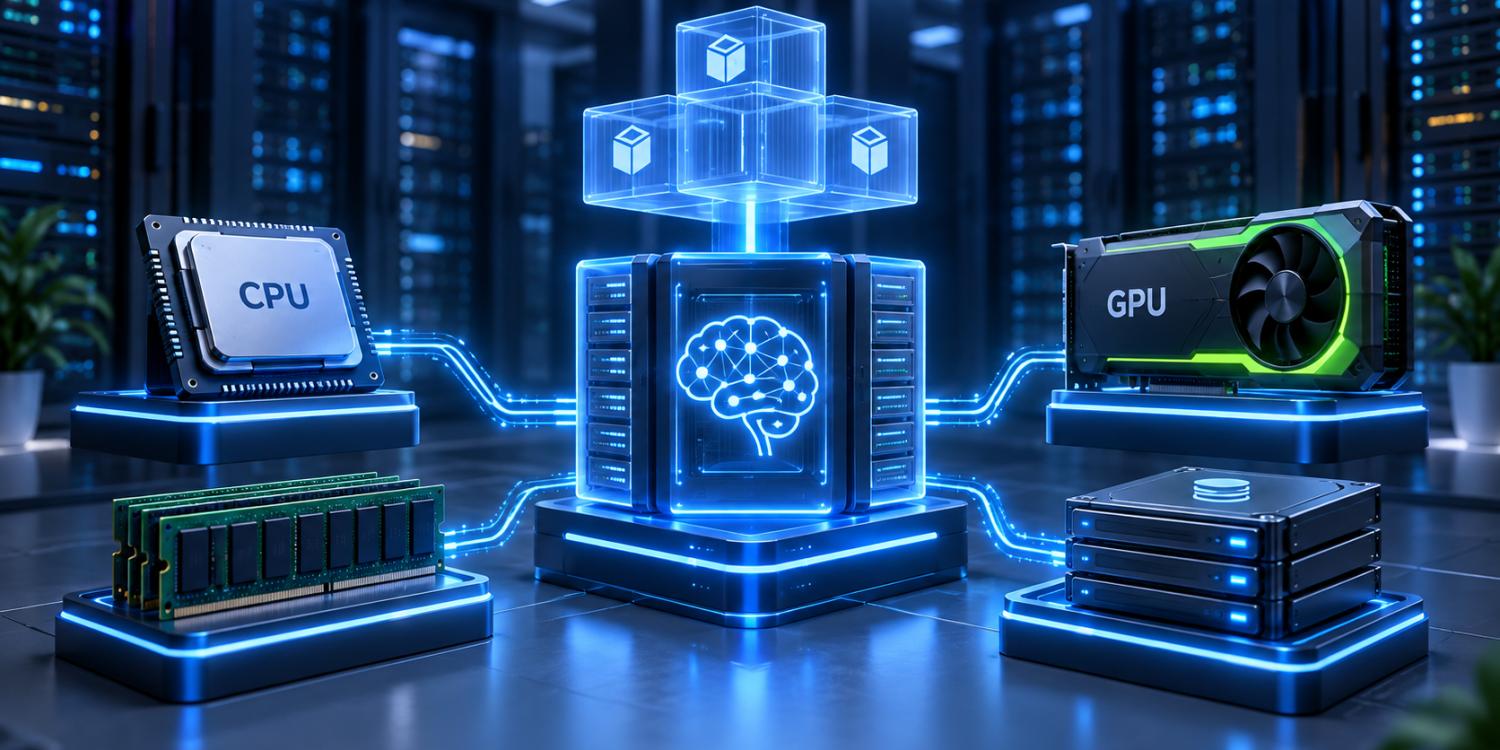
Разбираем, какие ресурсы нужны разным AI-сценариям: агентам через API, локальным моделям, RAG и системам автоматизации.
Содержание статьи:
- Когда достаточно CPU
- Роль оперативной памяти
- Когда нужен GPU
- Хранилище и RAG
- Не забывайте про сеть
- Вывод
AI-нагрузки отличаются сильнее, чем большинство обычных веб-приложений. Один сервис только отправляет запросы внешней модели, другой хранит большую базу знаний, третий запускает локальную LLM. Поэтому универсальной конфигурации «для AI» не существует.
Когда достаточно CPU
Для агентов, которые используют внешние API, основную работу по генерации выполняет сторонняя модель. Серверу остаются логика приложения, интеграции, базы данных и очереди. В таких сценариях VPS для AI-агентов может работать на обычной виртуальной инфраструктуре без GPU.
Роль оперативной памяти
RAM используют контейнеры, базы данных, кэш и фоновые процессы. Если сервис состоит из нескольких компонентов, память нужно считать по всему стеку. Нехватка RAM может приводить к перезапускам и нестабильной работе даже при невысокой загрузке CPU.
Когда нужен GPU
GPU становится важен для локального инференса моделей и задач, которые хорошо ускоряются на видеокартах. Требования зависят от конкретной модели, её размера и формата квантования. Доступность GPU-инфраструктуры у провайдера нужно подтверждать отдельно: обычный VPS не заменяет специализированный GPU-сервер.
Хранилище и RAG
Системы с документами и поиском по базе знаний могут хранить значительный объём исходных файлов, индексов, логов и резервных копий. Здесь важны и объём диска, и производительность операций ввода-вывода.
Не забывайте про сеть
При активной работе с внешними API, вебхуками и интеграциями стабильность сети влияет на весь сервис. Для корпоративных сценариев также важно продумать ограничения доступа, VPN и расположение данных.
Вывод
Инфраструктуру для AI выбирают от конкретной архитектуры. CPU и RAM закрывают множество агентских сценариев, GPU нужен не всегда, а диск и сеть часто недооценивают. Начинать стоит с профиля нагрузки, а не с максимальной конфигурации.
Статья добавлена 1 месяц назад. Автор - Blog Admin

Подпишитесь на новые статьи от Maxiplace
Смежные статьи
Защита от ботов и DDoS-атак для сайта
В этой статье мы подробно поговорим о таком явлении как парсинг, о том как защитить ваш сайт от вредоносных ботов, и что делать при DDOS-атаке на сайт.
Инструкция для Webasyst: перенос сайта на другой хостинг
Перенос сайта Webasyst на другой хостинг - проблема, которая часто возникает при естественном росте интернет-магазинов. Webasyst зарекомендовал себя как одна из самых гибких cms-платформ, особенно благодаря действительно качественному модулю для построения интернет-магазинов (shop-script). Перенос таких ресурсов можно произвести без потерь и лишних усилий, и в этой статье мы расскажем, как.
Как открыть свой интернет-магазин с нуля: пошаговая инструкция 2021
Рассказываем, как открыть свой интернет-магазин - о вариантах налогообложения, грамотном выборе сферы работы, поставщиков, создании портрета целевой аудитории, подборе названия и CMS